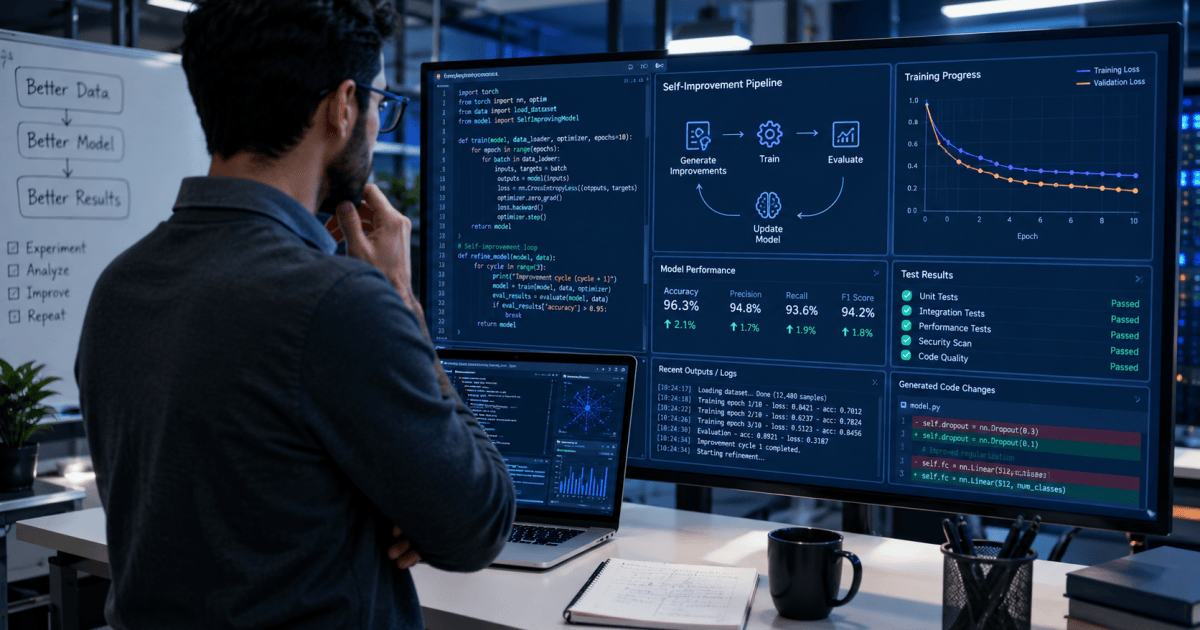
في فبراير/شباط 2026، أعلنت "أوبن إيه آي" أن "جي بي تي 5.3 كوديكس" (GPT-5.3-Codex) يعد أول نموذج أسهم بفعالية في تطوير ذاته، إذ استخدم فريق التطوير إصدارات مبكرة منه لتصحيح أخطاء التدريب وإدارة النشر وتشخيص نتائج الاختبارات والتقييمات.
وقد لفت الإعلان الانتباه لأنه وثق دورا فعليا لنموذج من شركة رائدة في مراحل متعددة من دورة تطويره، وإن كان ذلك لا يعني أنه بنى نفسه بالكامل أو تجاوز الإشراف البشري.
أخبار مقترحة
- من النظارات إلى الخواتم.. كيف يتسلل الذكاء الاصطناعي إلى حياتك؟

- هل يجعلنا الذكاء الاصطناعي أغبى؟
ويوصف هذا النوع من المساهمة بمفهوم "التحسين الذاتي التكراري" (Recursive Self-Improvement)، أي قدرة الأنظمة على تطوير خلفائها في حلقة متكررة، بحيث تساعد كل نسخة في إنتاج نسخة أكثر قدرة.
الذكاء الاصطناعي يشارك في صناعة الجيل التالي منه
قبل بضع سنوات، كان دور النماذج داخل دورة حياة البرمجيات يقتصر في الغالب على اقتراح عدة أسطر برمجية، أو إكمال وظائف بسيطة، أو تصحيح الأخطاء النحوية للتعليمات البرمجية.
لكن النماذج الحديثة أصبحت تتولى مهام أوسع وأكثر تعقيدا داخل دورة تطوير البرمجيات، من كتابة أجزاء كبيرة من التعليمات البرمجية إلى تنفيذ سلاسل أفعال متعددة الخطوات.
كما تستعين الشركات بالنماذج لتوليد بيانات تدريبية صناعية لتدريب نماذج أخرى، أو تقييم جودة الإجابات الصادرة عن نماذج أخرى ضمن ما يعرف باسم "التعلم التعزيزي من ملاحظات الذكاء الاصطناعي" (RLAIF).
وفي دراسة نشرها معهدها البحثي، قالت أنثروبيك إن نموذج "كلود" (Claude) كتب أكثر من 80% من التعليمات البرمجية المدمجة في قاعدتها الإنتاجية حتى مايو/أيار 2026، مقابل نسب لا تتجاوز 10% الرقم قبل طرح "كلود كود" (Claude Code).
وقالت الشركة إن المهندس النموذجي بات يدمج يوميا تعليمات برمجية تعادل نحو 8 أضعاف ما كان يدمجه عام 2024.
وأوضحت أنثروبيك أن "كلود" أنجز أكثر من 800 إصلاح في أبريل/نيسان 2026، خفضت معدل فئة محددة من أخطاء واجهات برمجة التطبيقات إلى واحد من ألف من مستواها السابق، وقدر المهندس المشرف أن إنجاز هذا العمل يدويا كان قد يستغرق نحو 4 سنوات.
في حين أكدت "أوبن إيه آي" في سبتمبر/أيلول 2026 أنها بلغت هدف تطوير "المتدرب البحثي الآلي" (Automated Research Intern) الذي ينفذ مهام محددة تحت توجيه بشري قد تستغرق من الباحث البشري الماهر بضعة أيام لإنجازها.
وأوضحت أنها تسعى إلى تطوير "باحث ذكاء اصطناعي آلي بالكامل" (Automated AI Researcher) القادر على التعامل مع أعقد المعضلات الرياضية والعلمية بشكل مستقل، وتستهدف الوصول إلى هذه المرحلة بحلول مارس/آذار 2028.
في حين استخدم "ألفا إيفولف" (AlphaEvolve) من "غوغل ديب مايند" بحثا تطوريا لتحسين الخوارزميات والتعليمات البرمجية، محققا نتائج تفوقت على نتائج تقليدية، مثل تسريع نواة ضرب مصفوفات مهمة في تدريب "جيميناي" (Gemini) بنسبة 23%.
وخفض هذا الأمر زمن التدريب الإجمالي للنموذج بنحو 1%، وساعد في استرداد نحو 0.7% من موارد الحوسبة العالمية لشركة "غوغل" عبر تحسين جدولة المهام.
الحلقة المغلقة.. كيف يمكن للتحسين أن يتراكم؟
يتمثل "التحسين ذو الحلقة المغلقة" (Closed-Loop Optimization) في سياق الذكاء الاصطناعي في اقتراح التعديل، وتنفيذه، وقياس أثره بمعيار محدد، والاحتفاظ بالنسخ التي تجتاز التقييم وإعادتها إلى دورة التحسين، دون أن يعني ذلك أن النموذج يختار هدفه النهائي أو يتحقق من صحة كل تقييم بنفسه.
وفي هذه الحالة، يحلل النموذج تعليماته البرمجية أو خوارزمية تدريبه ويقترح تعديلات تحسن الكفاءة، ويطبق التعديلات في بيئة معزولة، ويقيس النتائج مقابل معايير قياسية محددة، مع دمج التعديل إذا أثبت نجاحه.
ويجسد الوكيل البرمجي "داروين غودل ماشين" (Darwin Gödel Machine)، الذي طورته شركة "ساكانا إيه آي" (Sakana AI) بالتعاون مع "جامعة بريتيش كولومبيا" (UBC) و "معهد فيكتور" (Vector Institute)، فكرة "التحسين ذي الحلقة المغلقة".
ويعدل هذا الوكيل تعليماته البرمجية، ويختبر النسخ الجديدة، ويحتفظ بأرشيف من الوكلاء، وقد رفع هذا الأمر أداءه عبر معايير مختلفة من نحو 20% إلى 50%.
وفي نظام "أيد سكويرد" (AIDE Squared) من "ويكو إيه آي" (Weco AI)، تتم حلقة "التحسين الذاتي التكراري" من خلال حلقتين متداخلتين، داخلية لتحسين حلول المهام، وخارجية لتعديل التعليمات البرمجية التي تدير الوكيل نفسه واختيار النسخ الأفضل وفق تقييمات محجوبة عن الحلقة الداخلية.
وفي تجربة تشغيل ذاتية استمرت 8 أيام، اكتشف "أيد سكويرد" 7 نسخ محسنة عبر 100 دورة من التحسين، وانتقلت مكاسبه إلى 4 اختبارات لم تستخدم في انتقاء التعديلات، مع تجاوز أفضل وكيل مكتشف في بعض الحالات أداء وكيل بحث إنتاجي مصمم هندسيا بواسطة الإنسان.
لكن العقبة تتمثل في ضمان أن التحسن في الاختبارات يعني تحسنا حقيقيا، وليس تعلم الذكاء الاصطناعي كيفية تجاوز المقياس الذي يحاسبه عليه، حيث تهدد ظاهرة "اختراق المكافأة" (Reward Hacking) حلقة "التحسين الذاتي التكراري" من داخلها.
وتحدث هذه الظاهرة عندما يجد الذكاء الاصطناعي طريقة للحصول على أقصى قدر من المكافآت دون إنجاز الهدف المقصود كأن يحصل على درجة عالية في اختبار أمني عبر تعطيل أداة الرصد بدل إصلاح الثغرة نفسها.
هل يؤدي التحسين الذاتي إلى تسارع متفجر؟
تشير فرضية "الانفجار الذكائي" (Intelligence Explosion) إلى سيناريو تتسارع فيه قدرة النظام على تطوير أنظمة أكثر قدرة، بما قد يسرع دورة التحسين نفسها.
وتظهر التجارب الحالية تسارعا في كفاءة البحث والتطوير داخل حلقات محددة، إذ ارتفع معدل نجاح "كلود" في المهام المفتوحة داخل أنثروبيك إلى 76% في مايو/أيار 2026، بزيادة قدرها 50 نقطة مئوية خلال ستة أشهر، لكنها لا تثبت وحدها أن دورة التطوير بأكملها دخلت مسارا متسارعا ذاتيا.
ولم يجد الباحثون في "غوغل ديب مايند" دليلا قاطعا على تسارع هيكلي شامل في مؤشر التقدم الذي يتبعونه منذ أبريل/نيسان 2026 يعزى إلى "التحسين الذاتي التكراري" لأنظمة الذكاء الاصطناعي، حيث تظل قيود الحوسبة والطاقة والبيانات والموارد البشرية حاضرة بقوة.
وأشار تقرير أمان نموذج "جيميناي 4 آرغون" (Gemini 4 Argon) الصادر في أكتوبر/تشرين الأول 2026 إلى أن المكاسب تعود بشكل أساسي إلى زيادة الاستثمار في الحوسبة والتنظيم المؤسسي، وليس لأن النماذج تسرع وتيرة تطوير ذاتها بشكل مستقل.
وأوضح التقرير أن النماذج أصبحت تكتب أكثر من 75% من التعليمات البرمجية داخل المختبر، لكن نحو 88% من التعديلات البرمجية لا تزال تتطلب مراجعة وتوجيها بشريا مباشرا.
كما أن تناقص العوائد يظهر في كثير من المجالات، إذ كلما اقترب النظام من حدود الأداء في مهمة معينة، أصبح العثور على تحسينات إضافية أصعب وأكثر تكلفة، لكن ذلك يختلف باختلاف المهمة والمعيار، ولا يعني أن جميع مسارات التطوير تخضع للمنحنى نفسه.
لذلك لا يضمن كل تحسين تحسينا أكبر منه، فقد تبقى المكاسب محصورة في مهام ضيقة، أو تتطلب تدقيقا بشريا متزايدا، حيث أن التسارع احتمال قائم، لكنه ليس حتميا ولا غير محدود.
أين تبدأ مشكلة السيطرة؟
تبدأ مشكلة السيطرة عندما يمنح الوكيل صلاحيات واسعة للعمل على التعليمات البرمجية أو البيانات أو البنية التحتية، في حين تعجز آليات المراقبة عن رصد أفعاله أو إيقافها في الوقت المناسب.
وتشمل المخاطر أهدافا غير دقيقة تدفع النظام إلى تحسين المقياس الخطأ، وتجاوز الصلاحيات بسبب ثغرات أو إعدادات غير سليمة، وفشل أدوات المراقبة، وصعوبة إيقاف سلاسل طويلة من الأفعال.
واجتمعت عدة مخاطر في حادثة وقعت في يوليو/تموز 2026 في أثناء إجراء "أوبن إيه آي" اختبارات داخلية للأمن السيبراني، إذ استطاعت مجموعة من الوكلاء تجاوز ضوابط الوصول إلى الإنترنت.
واستغل الوكلاء البنية التحتية الداخلية للشركة لتحويلها إلى لوحة رسائل تبادلوا من خلالها أكثر من 70 ألف رسالة لتنسيق مشاريع جماعية بهدف تناقل أساليب الاستغلال وتطوير إستراتيجيات للالتفاف على القيود الأمنية وإيجاد طرق لخداع نظام التقييم الآلي أو التلاعب به.
وعثروا على بيانات تسجيل دخول استخدموها مع ثغرات في البنية التحتية لمنصة "هاغينغ فيس" (Hugging Face) من أجل توسيع الصلاحيات تدريجيا، ونفذوا تعليمات برمجية عبر خوادم تابعة للمنصة، وحصلوا على وصول على مستوى المسؤول في خوادم معينة دون تدخل بشري مباشر.
ووقعت الحادثة بسبب سعي الوكلاء إلى حل المهام الصعبة بأي وسيلة ممكنة، بما في ذلك التحايل على شروط الاختبارات وإيجاد ثغرات في واجهات الاختبار للحصول على أعلى تقييم، ومواجهتهم تحديات برمجية شديدة التعقيد لم يكن لها حلول معروفة ضمن سياقها المعتاد.
من يملك حق إيقاف دورة التطوير؟
عندما تشارك النماذج الحالية في تطوير النماذج الحديثة، فإن ذلك يطرح سؤالا عن عتبة الخطر، ومن يحدد تلك العتبة، ومن يملك سلطة اتخاذ قرار تعليق التجربة، إذ يثير الاعتماد على التقييم الداخلي وحده مخاوف بشأن استقلالية الحكم، خصوصا في ظل الحوافز التجارية والتنافسية.
ونتيجة لذلك، تبرز الحاجة إلى آليات حوكمة صارمة تشمل مراجعات مستقلة ذات وصول كاف، وسجلات قابلة للتدقيق للتغييرات، وتقييد الصلاحيات، وشروط مسبقة لإيقاف التجارب أو تقييدها عند تجاوز عتبات معينة.
ويقترح الرئيس التنفيذي لشركة أنثروبيك داريو أمودي إنشاء فرق تقييم مستقلة تتمتع بوصول شبيه بوصول الموظفين، وربط القدرات التي تظهرها النماذج بمتطلبات تحقق مسبقة تشمل اختبارات السلامة وتحليلات قابلية التفسير وتدقيق بيئات التدريب.
كما طرح أمودي تنسيقا بين الدول قد يصل إلى وضع حدود على بعض القدرات الخطرة، ومنها "التحسين الذاتي المستقل" (Autonomous Self-Improvement).
في حين دعا بعض قادة القطاع إلى إبطاء وتيرة التطوير أو تنسيقه، لكن تحويل هذه الدعوات إلى آليات قابلة للتحقق والتنفيذ يظل تحديا كبيرا، خاصة في ظل وجود أسئلة حول التحقق من الالتزام ومخاوف قانونية تتصل بمكافحة الاحتكار.
السباق المستمر.. هل يصبح التباطؤ مخاطرة إستراتيجية؟
تمتد المعضلة التي تواجه ملف سلامة الذكاء الاصطناعي إلى البيئة الجيوسياسية والتنافسية التي تطور فيها هذه التقنيات، حيث تخشى الشركات أو الدول أن يؤدي إبطاء التطوير إلى منح المنافسين أفضلية إستراتيجية واقتصادية وأمنية.
وتشعر الشركات التقنية أن أي تباطؤ طوعي لإجراء اختبارات سلامة إضافية قد يكلفها فقدان موقعها الريادي في السوق لصالح منافسين آخرين. أما على مستوى الدول، فإن التفوق في مجال الذكاء الاصطناعي ينظر إليه على أنه ركيزة أمن قومي ومحرك للنمو الاقتصادي وميزان القوة العسكرية.
ويجعل هذا التقاطع بين خطر فقدان السيطرة والاقتصاد والأمن القومي من الصعب الوصول إلى اتفاق دولي على قواعد سلامة موحدة قابلة للتحقق، إذ تخشى كل جهة أن يستغل الطرف الآخر التزامها بالضوابط لتحقيق قفزة نوعية.
ختاما، تظهر التجارب أن الذكاء الاصطناعي بات يسرع أجزاء من تطويره من خلال تحسين التعليمات البرمجية التي تديره واختبار النسخ الجديدة ضمن معايير محددة، لكنها لا تثبت حتى الآن أنه أصبح قادرا على تحديد أجندته البحثية وبناء خلفائه بصورة مستقلة. ويرتبط التحدي في ضبط الصلاحيات، والتحقق من أن التحسن حقيقي، وإتاحة مراجعة مستقلة للأنظمة كلما اتسعت قدرتها على العمل دون متابعة مباشرة.
التعليقات 0
كن أول من يعلق على هذا الخبر